keskiviikko 30. kesäkuuta 2010

Cisco UCS part #1 - perusjuttuja

Yritän tässä kasailla nyt kesän, syksyn aikana asennus yms. juttuja Ciscon UCS:stä. (Unified Computing System). Ensin kasataan itse UCS, tehdään sille kahdennettu verkko, liitetään Netapp storageen; sekä FC, että NFS. Tämänjälkeen laitetaan ESX pystyyn, tehdään VNLinkillä yhteyksiä ja katsotaan miten kaikki saadaan toimimaan nätisti keskenään.

Cisco toi UCS:n (aka. Project California) vähän aikaa sitten markkinoille. Sen tarkoitus olisi Ciscon sanoin yhdistää niin verkko, levy (storage), palvelin virtualisointi yhdeksi kokonaisuudeksi.

Ciscon ajattelutapa eroaa aika paljon siinä, että kehikon "aivot" tuodaan kytkimeen sensijaan, että jokaisessa kehikossa olisi omat "aivot", kuten mm. HP ja Dell tekee. Tämä tietysti auttaa siinä, että kehikko itsessään on vain rautaa ja hintaa saadaan siinä alaspäin, joskin kytkimet tietysti maksavat enemmän. Samoin Ciscon PALO-kortti (M81KR) on erittäin mielenkiintoinen ja tarjoaa varmasti jännittäviä konffaushetkiä ja vähän muuttaa tapoja tehdä asioita.

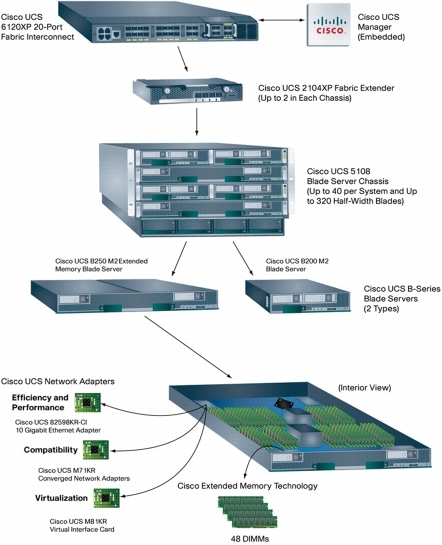
Hommahan koostuu alla olevan kuvaisesti seuraavista komponenteista (Ciscon sivuilta poimittu kuva)

Alhaalta ylöspäin. Taino, keskeltä alas ja sitten ylös.

Keskellä on kehikko (5100 malli), johon saa 8 puolileveää tai 4 täysleveää palveinta kiinni.
Taakse laitetaan 2 kpl Fabric Extenderit (UCS 2104XP), joista yhdestä FEX:istä saa 4 kpl 10G yhteyttä kiinni UCS-kytkimiin. Kehikossa on 8 tuuletinta. Sähköä se muistaakseni söi 4 x 2500W powereita, jotka pystyivät olemaan muutamalla eritavalla kytkettyinä. Itse suosisin n+1 mallia. Korkeus on 6RU.

Kehikossa itsessään ei ole mitään älyä, joten siitä ei ole kauheasti mitään sen ihmeellisempää kerrottavaa.

Bladeja taitaa tällä hetkellä olla saatavilla B200 (puolileveä) ja B250 (täysleveä).
B2x0 -sarjalaiset tukevat Intelin 55xx prosessoreja. Ilmeisesti on tullut myös B4xx sarjalaisia, joissa on sitten Intelin 56xx ja 75xx malleja, mutta niistä en tiedä sen tarkemmin.
B200:een saa maksimissaan 96GB muistia (12DIMM) ja B250 tukee 384GB (48DIMM).

B200 saa yhden mezzanine kortin ja B250:een 2. Näinollen B200 thruput on 20Gbps max ja B250 40Gbps.

Mezzanine kortteja on seuraavanlaisia:

 • Cisco UCS 82598KR-10 Gigabit Ethernet Network Adapter

• Cisco UCS M71KR-Q QLogic Converged Network Adapter

• Cisco UCS M71KR-E Emulex Converged Network Adapter

• Cisco UCS M81KR Virtual Interface Card


Tulen käymään läpi tuota M81KR korttia enemmän jatkossa, koska tuo on yksi syy, miksi Ciscon UCS on kiinnostava.

Kehikosta mennään FEX:in kautta UCS kytkimiin (6120/6140 mallit). FEX:stä kytkimiin laitetaan kaapeleita tarpeen mukaan. Muistaakseni joko 1,2 tai 4 10G yhteyttä (per FEX). Maksimi thruput on silloin 80Gpbs per kehikko.

UCS kytkimistä (Fabric Interconnect) sitten tulee ihan omia juttuja. Kytkimissä on oikeastaan kaikki mitä UCS itsessään on. Yhteen UCS järjestelmään voi kytkeä 40 UCS kehikkoa (max 320 puolileveää palvelinta). Jokatapauksessa kytkimessä on 20 tai 40 10Gpbs porttia (SFP+) ja lisämahdollisuutena voi siihen laittaa 8 porttisen 1/2/4Gbps FC (Fiber Channel) kortin, 6 porttisen 1/2/4/8Gbps FC-kortin, 6 porttinen 10Gbps eth-kortti tai 4 FC + 4 eth 10Gbps kortin.

Hyvä, sekava kirjoitus.. kyl tää tästä :)

Netapp: Metroclusterin peilauksen purkaminen

Lyhyt ohje peilauksen purkamiseen metroclusterissa. Peilaus on ainakin hyvä purkaa, jos clusterin jäsenet ovat pitkään irti toisistaan. 

Peilauksen purku ei aiheuta mitään katkoksia tuotantoon. Lähinnä se aiheuttaa vaan jännitystä, kun pelottaa jos jokin menee pieleen :)
Ensin kannattaa katsoa kumpi on paikallinen levyosio ja kumpi peilipuolisko, jotta tietää kumman haluaa ottaa irti. Alla olevasta näkee sen parhaiten oikeastaan kytkiten nimistä jos ne on nimetty "järkevästi". Tässä tapauksessa plex1 on peiliosio.

Seuraavalla komennolla näkee aggrekaatin rakenteen:

netapp-a> aggr status -r aggr0
Aggregate aggr0 (online, raid_dp, mirrored) (block checksums)
  Plex /aggr0/plex0 (online, normal, active, pool0)
    RAID group /aggr0/plex0/rg0 (normal)


      RAID Disk Device               HA  SHELF BAY CHAN Pool Type  RPM  Used (MB/blks)    Phys (MB/blks)
      --------- ------               ------------- ---- ---- ---- ----- --------------    --------------
      dparity site1-san-be-sw2:3.16 0c    1   0   FC:A   0  FCAL 10000 272000/557056000  280104/573653840
      parity   site1-san-be-sw1:3.17 0a    1   1   FC:B   0  FCAL 10000 272000/557056000  280104/573653840
      data     site1-san-be-sw2:3.18 0c    1   2   FC:A   0  FCAL 10000 272000/557056000  280104/573653840
      data     site1-san-be-sw1:3.19 0a    1   3   FC:B   0  FCAL 10000 272000/557056000  280104/573653840
jne...


  Plex /aggr0/plex1 (online, normal, active, pool1)
    RAID group /aggr0/plex1/rg0 (normal)


      RAID Disk Device               HA  SHELF BAY CHAN Pool Type  RPM  Used (MB/blks)    Phys (MB/blks)
      --------- ------               ------------- ---- ---- ---- ----- --------------    --------------
      dparity site2-san-be-sw1:5.16 0a    1   0   FC:B   1  FCAL 10000 272000/557056000  280104/573653840
      parity   site2-san-be-sw1:5.17 0a    1   1   FC:B   1  FCAL 10000 272000/557056000  280104/573653840
      data     site2-san-be-sw1:5.18 0a    1   2   FC:B   1  FCAL 10000 272000/557056000  280104/573653840
      data     site2-san-be-sw1:5.19 4b    1   3   FC:B   1  FCAL 10000 272000/557056000  280104/573653840
jne...

Sitten vaan splitataan aggrekaatti.
Täältä löytyy koko aggr komennon manuaali: http://www.wafl.co.uk/aggr-2/

Tuo split tekee siis sen, että sille ensin kerrotaan kumpi plexeistä irroitetaan pois. Eli halutaan se peilattu osio irti. Tämän jälkeen se luo uuden aggrekaatin, esimerkissä aggr99 -nimisen. Tämän jälkeen aggr0 ja aggr99 on täysin identtiset ja aggr99:n alla on samat volumet kuin aggr0:ssa. Kaikki volumet kuitenkin pistetään offline tilaan, jotta konflikteja ei tapahdu. Tämä myös näkyy tuossa esimerkissä.

netapp> aggr split /aggr0/plex1 aggr99

Mon Jun 28 12:27:35 EEST [netapp: fmmb.lock.disk.remove:info]: Disk site1-san-be-sw1:5.17 removed from local mailbox set.

Mon Jun 28 12:27:35 EEST [netapp: fmmb.lock.disk.remove:info]: Disk site1-san-be-sw1:5.16 removed from local mailbox set.
Mon Jun 28 12:27:37 EEST [netapp: fmmb.current.lock.disk:info]: Disk site2-san-be-sw1:3.17 is a local HA mailbox disk.
Mon Jun 28 12:27:37 EEST [netapp: fmmb.current.lock.disk:info]: Disk site2-san-be-sw2:3.16 is a local HA mailbox disk.
Mon Jun 28 12:27:37 EEST [netapp: wafl.vv.regen.FSID:notice]: For flexible volume 'root' (created via a split of a formerly mirrored-aggregate), regenerated FSID (0d31bba4) host 0.
Mon Jun 28 12:27:37 EEST [netapp: wafl.vv.rename.dup:notice]: Duplicate volume name 'root' detected and renamed to 'root(1)'
Mon Jun 28 12:27:37 EEST [netapp: wafl.vv.regen.FSID:notice]: For flexible volume 'testi' (created via a split of a formerly mirrored-aggregate), regenerated FSID (2731bba4) host 0.
Mon Jun 28 12:27:37 EEST [netapp: wafl.vv.rename.dup:notice]: Duplicate volume name 'testi' detected and renamed to 'testi(1)'
Split of formerly-mirrored aggregate aggr0 completed, new aggregate aggr99 created.
Mon Jun 28 12:27:38 EEST [netapp: lun.newLocation.offline:warning]: LUN /vol/testi(1)/lun17 has been taken offline to prevent map conflicts after a copy or move operation.


Eikä siinä muuta. Kannattaa tietysti tarkistaa, että kaikki toimii ok tuon jälkeen.

Jossain vaiheessa pistän infoa, miten peilaus rakennetaan uusiksi.

UPDATE:

Tämä uusi Aggr99 kannattaa ehdottomasti pistää offline tilaan, ennenkuin edes miettii metroclusterin takasnostamista, tai kaapeleiden yhdistämistä niin, että netapp voi nähdä toisensa. Jos tätä ei tee, niin on mahdollisuus, että netapp jossain vaiheessa panikoi.

Zimbra: lista kaikista alias domaineista

Enpä löytänyt mitään keinoa, millä zimbrassa saisi listattu kaikki alias domainiksi määritellyt domainit, joten ainoa millä sen jotenkin järkevästi sai oli ldapsearch:

Tyyliin:

/opt/zimbra/bin/ldapsearch -H ldap://ldap.testi.fi:389 -w salakala -D uid=zimbra,cn=admins,cn=zimbra -x "(&(objectClass=zimbraDomain)(zimbraDomainType=alias))" | grep ^#

Saa tulosteeksi tyyliin:

# testi.fi


LDAP salasanan saa esille:


zmlocalconfig -s ldap_root_password

tiistai 22. kesäkuuta 2010

Linux: webdav (pikainen käyttöönotto)


Pikainen ohje, miten webdavin saa toimimaan Debianissa. Tää on ihan HTTP:n päällä, mutta saman voi väkertää HTTPS:n päälle jos tuntuu siltä.

Lisätään apachen modulit:

[130 root@locutus ~]# a2enmod dav_fs
Considering dependency dav for dav_fs:
Enabling module dav.
Enabling module dav_fs.
Run '/etc/init.d/apache2 restart' to activate new configuration!


[130 root@locutus ~]# a2enmod dav_lock
Enabling module dav-lock.
Run '/etc/init.d/apache2 restart' to activate new configuration!

Käynnistetään apache uusiksi:


[root@locutus ~]# /etc/init.d/apache2 restart

Luodaan hakemisto, mikä jaetaan:

[root@locutus /var/www/borgship]# mkdir web
[root@locutus /var/www/borgship]# chown www-data:www-data web
[root@locutus /var/www/borgship]# chmod 777 web

Tehdään käyttäjätunnus-tiedosto ja käyttäjätunnukset, sekä laitetaan tiedoston oikeudet kuntoon:

[root@locutus /var/www/borgship]# cd web 
[root@locutus /var/www/borgship/web]# htpasswd -c passwd.dav toni
New password: 
Re-type new password: 
Adding password for user toni
[root@locutus /var/www/borgship/web]# htpasswd passwd.dav borgship.net\\toni
New password: 
Re-type new password: 
Adding password for user borgship.net\toni
[root@locutus /var/www/borgship/web]# chown root:www-data passwd.dav 
[root@locutus /var/www/borgship/web]# chmod 640 passwd.dav 
[root@locutus /var/www/borgship/web]# 

Muokataan sivuston asetuksia:

[root@locutus /var/www/borgship/web]# vi /etc/apache2/sites-available/borgship.net

Lisää rivit:


        Alias /webdav /var/www/borgship/web


        <Location /webdav>
           DAV On
           AuthType Basic
           AuthName "webdav"
           AuthUserFile /var/www/borgship/web/passwd.dav
           Require valid-user
           <LimitExcept GET PUT HEAD OPTIONS POST>
              Require valid-user
           </LimitExcept>
       </Location>


Tallenna ja restarttaa taas apache.

Testataan:


[root@locutus ~]# cadaver http://borgship.net/webdav/           
Authentication required for webdav on server `borgship.net':
Username: toni
Password: 
dav:/webdav/> ls
Listing collection `/webdav/': succeeded.
        passwd.dav                            82  kesä   22 20:06
dav:/webdav/> 

Sitten tän voi vaikka ubuntussa mounttaa Places -> Connect Network ja saa levyn jaettua.

maanantai 21. kesäkuuta 2010

Redhat: prosessin lisääminen käynnistykseen

Skripti pitää olla paikallaan /etc/init.d/ hakemistossa (redhatissa init.d on symlink /etc/rc.d/init.d)

esim: 


[root@dns /etc/rc.d/init.d]# ls -ld pdns
-rwxr-xr-x 1 root root 2735 Jun  3 14:30 pdns

Kun tiedosta katsoo, skriptin alussa on jotain tyyliin:

# chkconfig: - 80 75
# description: PDNS is a versatile high performance authoritative nameserver

Siinä kerrotaan miten chkconfig ottaa runlevelit ja missä vaiheessa prosessi käynnistetään bootissa.

listaa käynnistysprosessit:
#% chkconfig --list 

Sitten lisätään ks. prosessi mukaan:
#% chkconfig --add pdns
#% chkconfig on pnds

#% chkconfig --list pdns   

pdns           0:off 1:off 2:on 3:on 4:on 5:on 6:off

Jos vaikka halutaan, että pdns käynnistyy vain init-level 3:lla, voidaan sanoa:
#% chkconfig --levels 245 pnds off


VMware: Video card RAM

Tuli tänään tämmöinen virhe, kun VMotion siirtää konetta:


Insufficient video RAM. The maximum resolution of the virtual machine will be limited to 1176x885 at 16 bits per pixel. To use the configured maximum resolution of 2360x1770 at 16 bits per pixel, increase the amount of video RAM allocated to this virtual machine by setting svga.vramSize="16708800" in the virtual machine's configuration file.


Katselin koneita läpi, niin ilmeisesti jos hardware version VM:ssä on vielä 4, niin se pistää Video RAM:ksi 4MB, kun taas HW-version 7 koneet ovat automatic asetuksilla. Ongelmasta pääsee, kun laittaa ne koneet automatic asetukselle. 


Näytti olevan KB siitä: http://kb.vmware.com/selfservice/microsites/search.do?language=en_US&cmd=displayKC&externalId=1014593

lauantai 19. kesäkuuta 2010

esxtop

Tuosta SIOC-jutusta tuli mieleen, että näin voi katsoa niitä koneiden latensseja:

#% esxtop


: paina v (disk VM)
: paina f (add more fields)
: paina j (LATSTATS/cmd = Overall Latency Stats (ms)) -- ehkä myös k, l, m (riippuu mitä haluaa nähdä)

sitten siellä näkyy DAVG/cmd, josta voit nähdä latenssiaikoja.

Hyvä ohje esxtopin saloihin: http://communities.vmware.com/docs/DOC-9279